

César Hernandez Alvarez
À propos de moi
Research Scientist avec un doctorat en ingénierie médicale, spécialisé dans le deep learning appliqué aux signaux physiques complexes. Mes travaux doctoraux portaient sur la reconstruction d’objets cachés dans des milieux diffusants, un problème qui exigeait de comprendre la physique de la lumière avant d’écrire la moindre ligne de code. Ce socle façonne ma façon d’aborder chaque problème de modélisation.
Je conçois et évalue des modèles de bout en bout, de la curation des données brutes et des décisions de prétraitement jusqu’à l’entraînement depuis zéro, l’analyse des échecs et le déploiement de démos interactives. J’ai entraîné des architectures avec plus de 50M de paramètres sur des datasets de plus de 600K images et traduit des expériences de recherche en outils accessibles sur Hugging Face. J’élargis actuellement mes travaux vers l’imagerie médicale multimodale et les problèmes à données limitées, où bien évaluer le modèle compte autant que bien le construire.
Projets et contributions
Pour en savoir plus sur un projet spécifique, consulter le dépôt ou essayer une version de démonstration, cliquez sur les liens correspondants présents sur chaque carte.
Imagerie optique en milieu diffusant (thèse de doctorat)
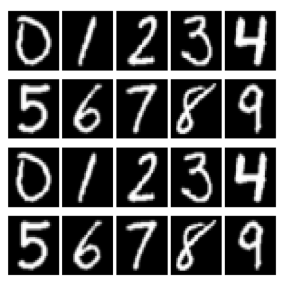
L’objectif de ce projet était d’améliorer la qualité des reconstructions en imagerie optique à travers des milieux diffusants, tout en réduisant le caractère aléatoire inhérent à ce type de reconstruction.
Article sur les hyperparamètres pour les processus d’optimisation
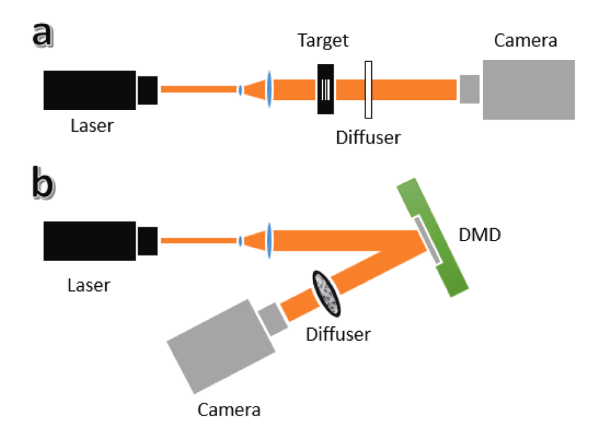
Cet article décrit une méthode permettant de réduire le temps de calcul et la nécessité d’une intervention humaine lors du réglage des paramètres de l’algorithme PSO appliqué à la reconstruction d’images.
Détection d’instruments chirurgicaux – Vidéo laparoscopique
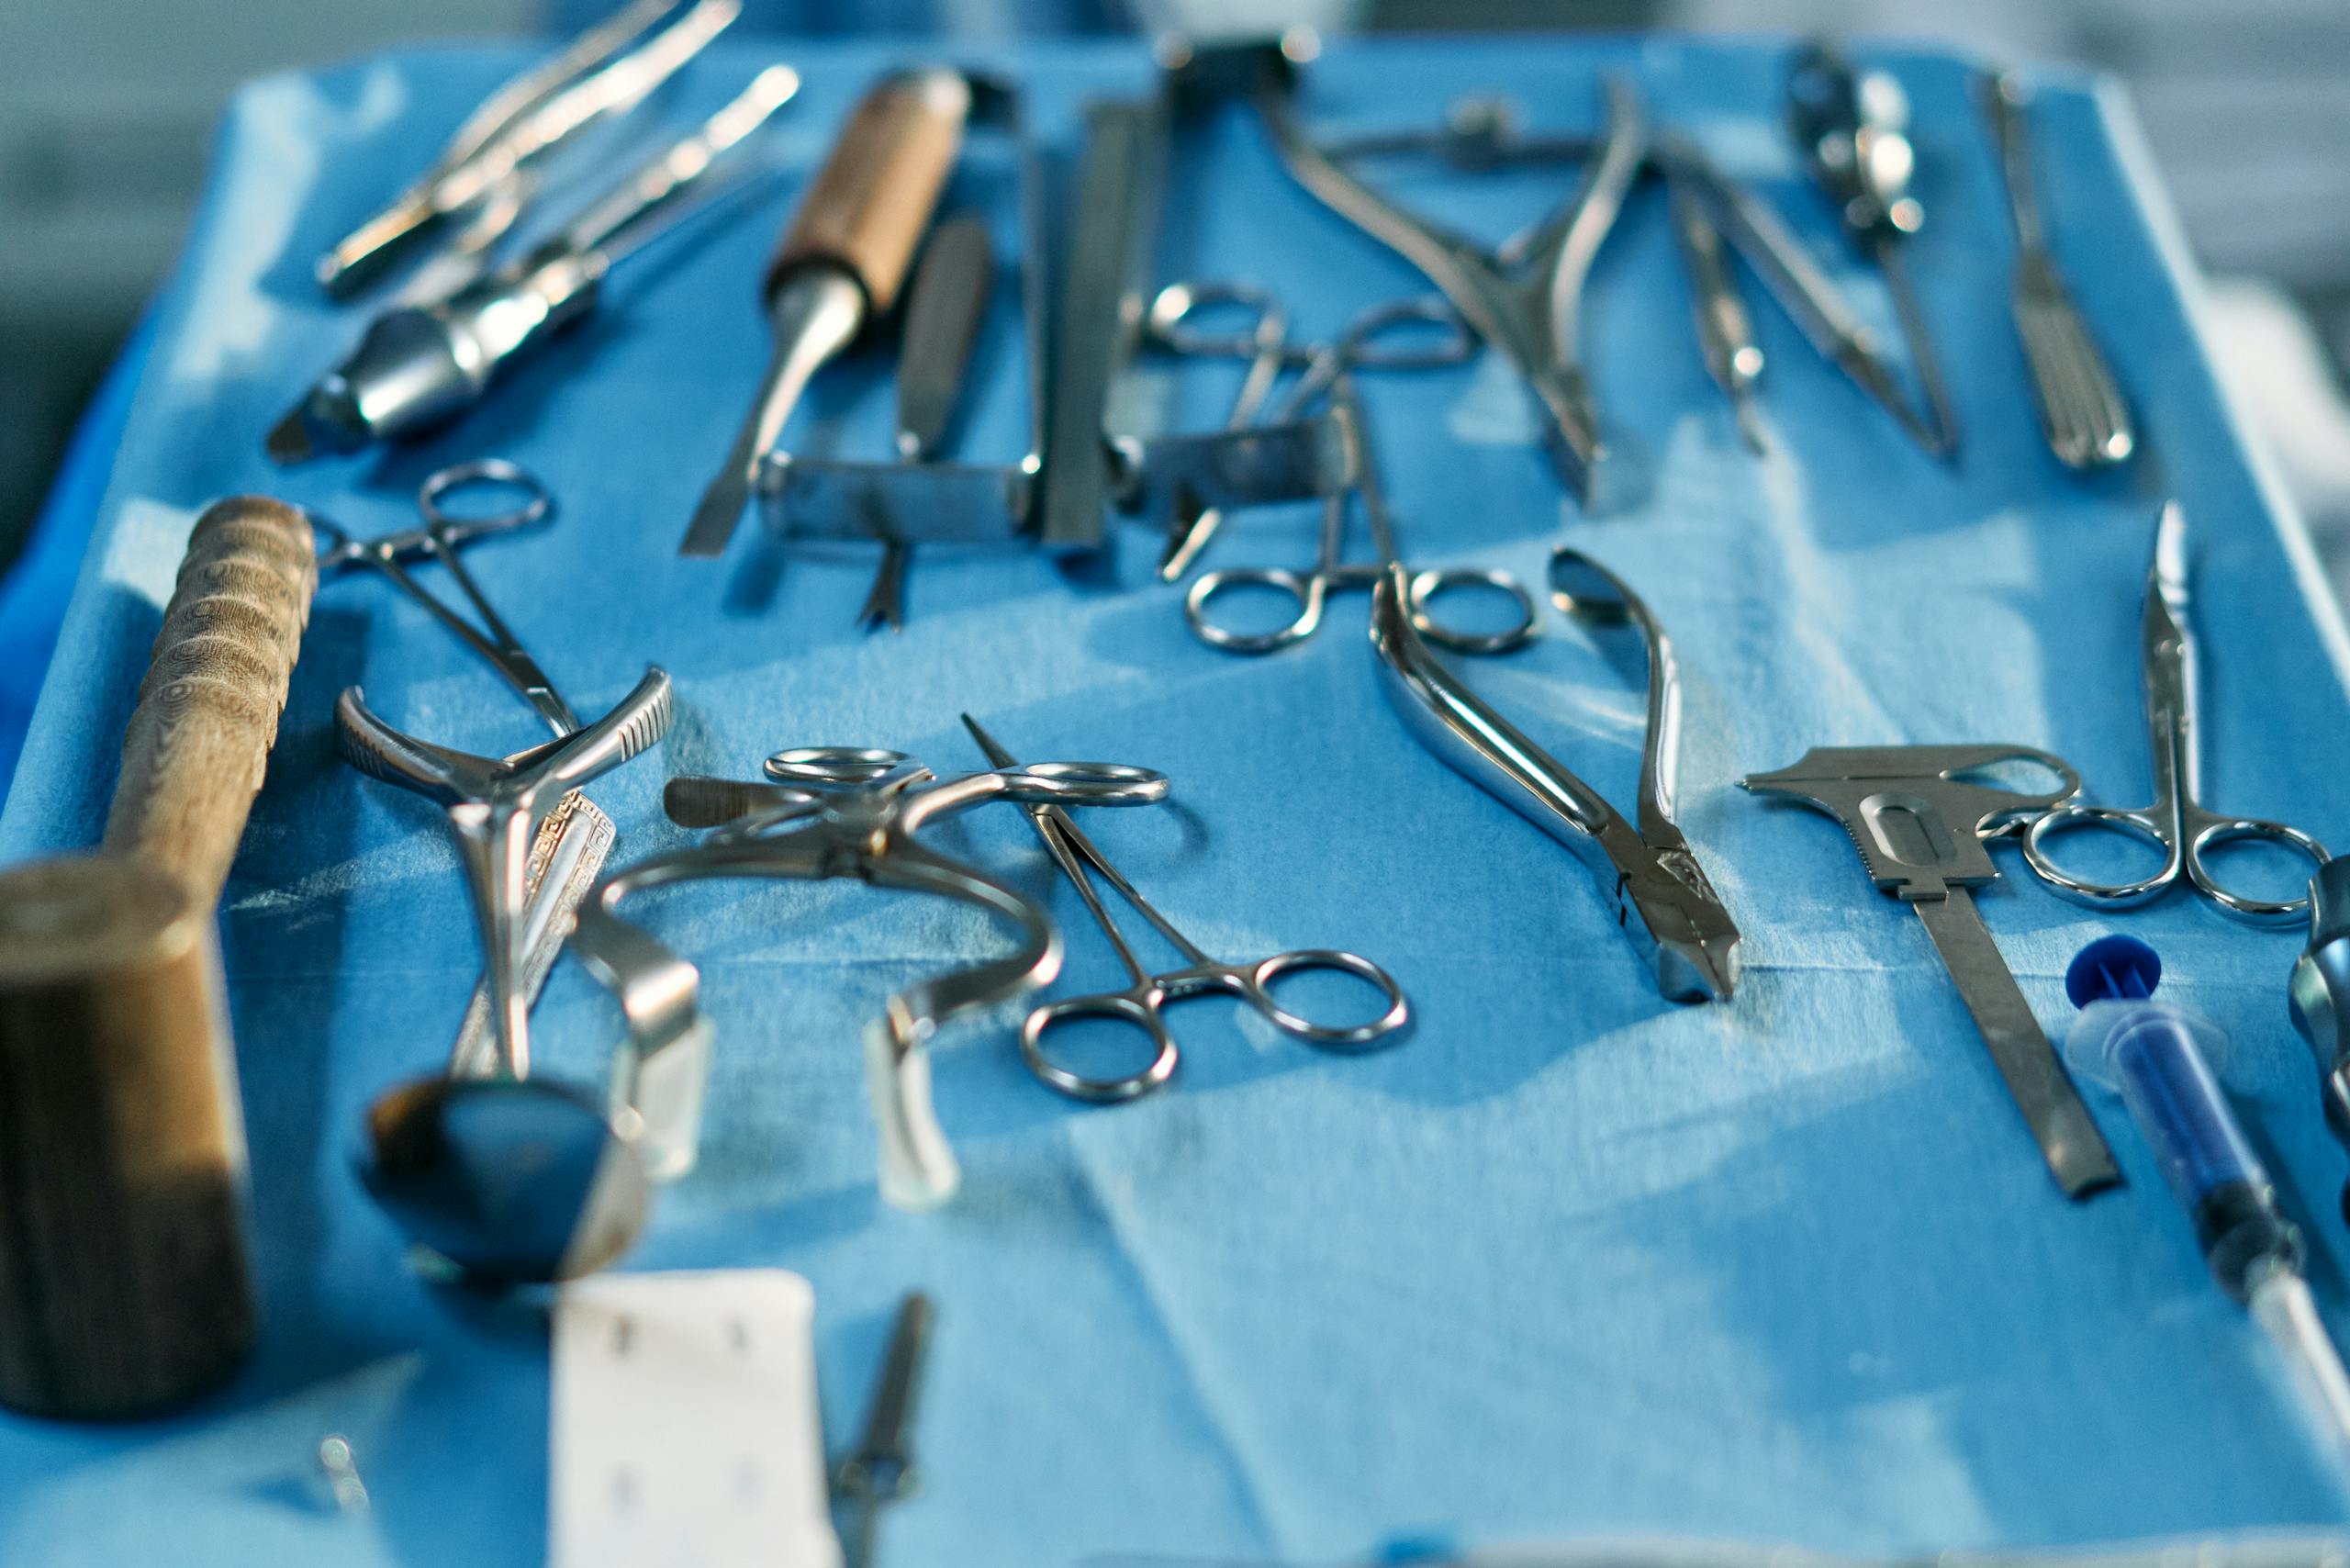
Une étude de fine-tuning appliquant YOLOv8s à la détection d’instruments chirurgicaux sur 7 classes, avec une analyse des échecs par classe, un cadre d’évaluation documenté et une démo interactive en direct.
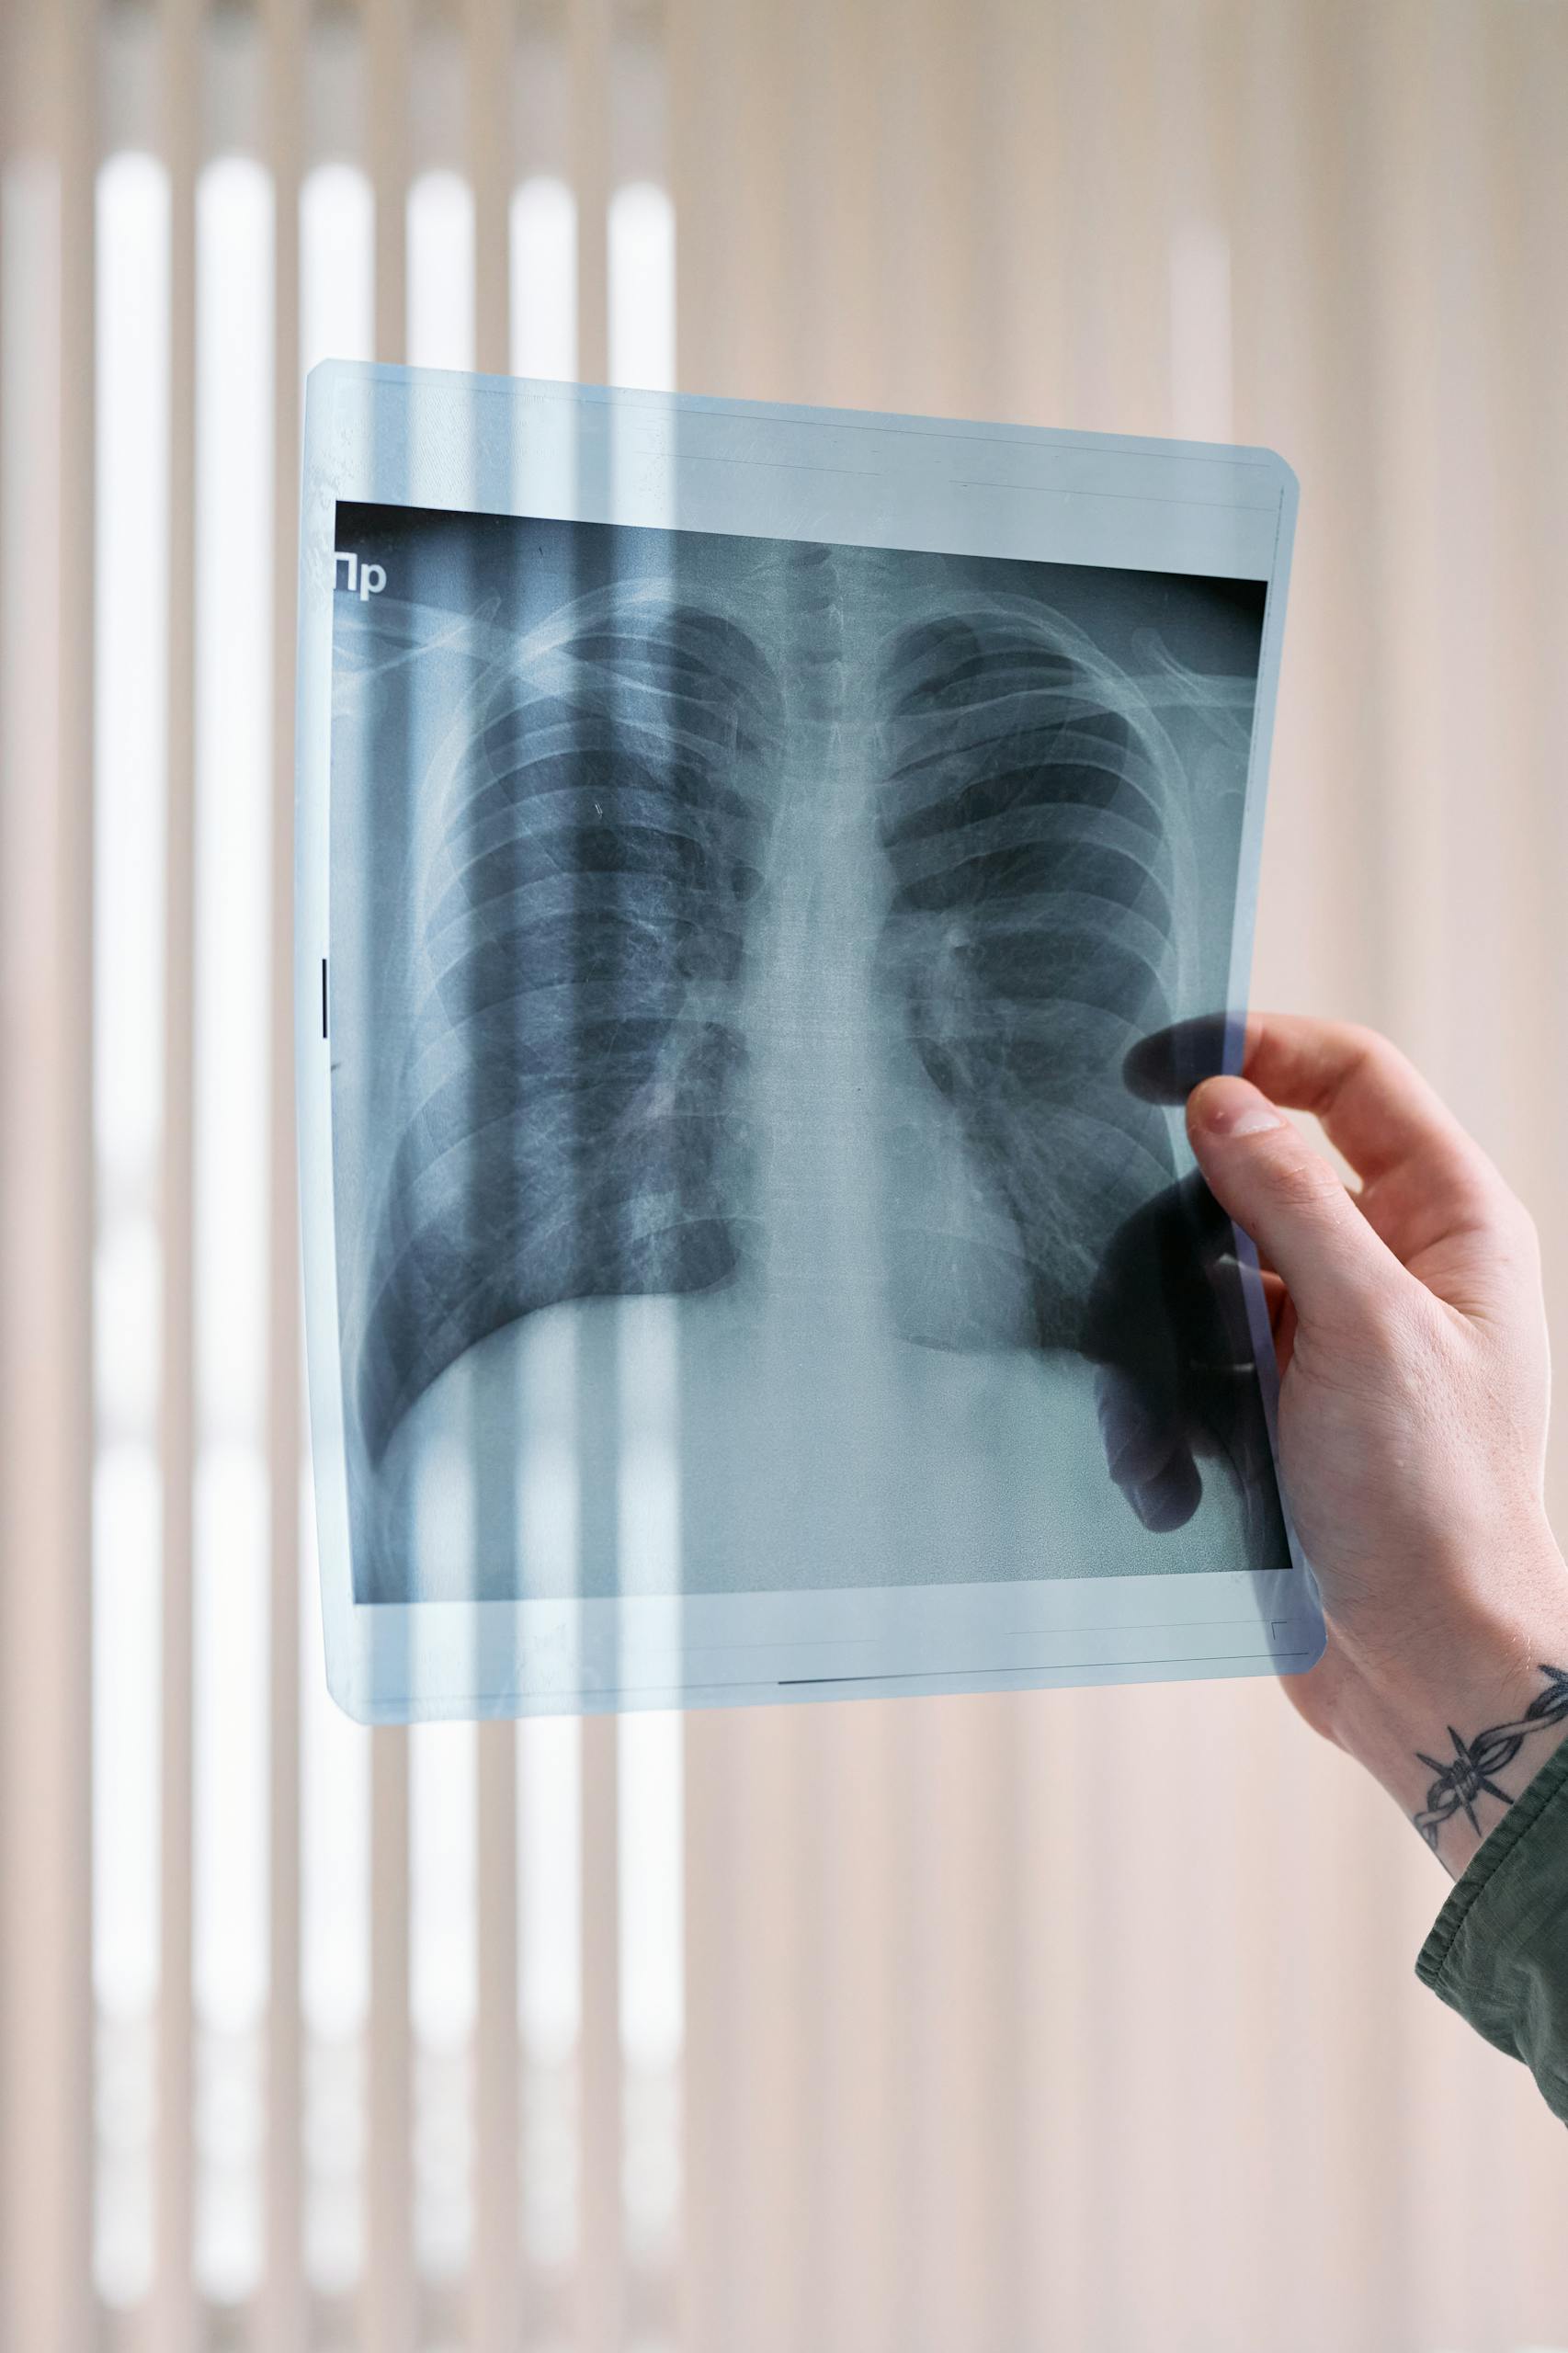
Détection de pneumonie sur radiographies thoraciques — Comparaison par Transfer Learning
Une étude de Transfer Learning comparant un ViT fine-tuné depuis zéro à un modèle spécialisé de référence, avec des visualisations Grad-CAM côte à côte et une démo interactive.
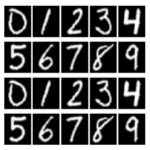
Imagerie optique en milieu diffusant (thèse de doctorat)
Les milieux turbides (ou diffusants) désignent des matériaux qui ne laissent pas passer la lumière, comme les substances opaques. Le principal défi dans l’application des algorithmes de reconstruction d’images basés sur le Deep Learning est que chaque modèle est spécifique au milieu sur lequel il a été entraîné. Si le milieu change, même lorsque l’objet reste identique, les performances du modèle chutent fortement.
Ce problème devient encore plus complexe dans le cas de la peau humaine, qui constitue un milieu dynamique. Même lorsque les données d’entraînement sont collectées à partir d’une seule personne, les propriétés optiques de la peau évoluent dans le temps, ce qui signifie que les conditions observées lors de l’entraînement ne sont pas stables.
L’objectif de cette thèse était d’améliorer la capacité de généralisation des modèles d’imagerie basés sur le Deep Learning pour la reconstruction d’objets cachés derrière ou à l’intérieur de milieux diffusants dans des systèmes optiques. Pour cela, plusieurs architectures de réseaux et stratégies de paramétrisation ont été explorées.
Les modèles présentés — Dense CNN et U-net — ont été entraînés à partir d’images de distributions d’intensité (appelées speckles) ainsi que d’informations dans le domaine de Fourier dérivées de ces speckles, en particulier les données d’autocorrélation et de spectre de Fourier. L’analyse complète et les résultats sont disponibles dans la thèse publiée, accessible via le lien indiqué sur la carte du projet.
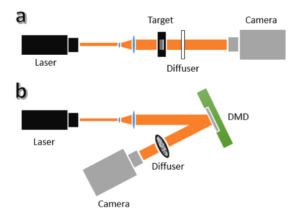
Article de revue sur l’ajustement des hyperparamètres pour les processus d’optimisation
L’imagerie à travers des milieux diffusants représente un défi majeur en optique, car l’information de phase de la lumière est perdue dans les figures de speckles enregistrées derrière un diffuseur ou un autre milieu complexe. Les algorithmes classiques de récupération de phase peuvent reconstruire l’objet caché à partir de mesures d’intensité, mais ils dépendent fortement de paramètres choisis par l’utilisateur (par exemple des réglages de filtres ou des seuils), généralement définis à partir d’une connaissance préalable des caractéristiques de l’objet — une information indisponible dans des applications réelles.
Ce travail publié propose l’utilisation de l’optimisation par essaim de particules (Particle Swarm Optimization, PSO), un algorithme de recherche inspiré de processus biologiques, afin de déterminer automatiquement les valeurs optimales des paramètres pour la récupération de phase, supprimant ainsi le besoin de réglages manuels ou d’hypothèses spécifiques sur l’objet. En combinant le PSO avec une approche d’imagerie en prise unique basée sur des speckles modulés par l’objet, la méthode permet une convergence plus rapide et une meilleure qualité de reconstruction, sans recherches répétées des meilleurs paramètres.
Cette étude met en évidence l’intérêt de combiner des techniques d’optimisation avec la récupération de phase optique afin de rendre l’imagerie basée sur les speckles plus robuste et plus exploitable, en particulier lorsque les informations préalables sur l’objet sont indisponibles.
Détection d’instruments chirurgicaux – Vidéo laparoscopique
La détection d’instruments chirurgicaux en vidéo laparoscopique se situe à l’intersection de deux problèmes difficiles : une distribution de classes fortement déséquilibrée et un écart de domaine significatif entre les modèles de vision généralistes et les réalités d’un environnement chirurgical. Ce projet examine dans quelle mesure un modèle de détection pré-entraîné peut se transférer à ce domaine avec des données annotées limitées.
Le modèle utilisé est YOLOv8s, pré-entraîné sur COCO, un dataset de détection généraliste à grande échelle comprenant 80 classes d’objets. Aucune de ces classes n’est un instrument chirurgical. La question était de savoir si les représentations visuelles apprises sur des images naturelles se transféreraient de manière significative à un domaine clinique spécialisé, et où exactement ce transfert échoue.
Le fine-tuning a été réalisé sur le dataset Cholec80-boxes, couvrant 7 classes d’instruments sur 14 195 frames annotées. La distribution des classes est fortement asymétrique : l’instrument Hook domine le dataset, tandis que des classes comme Clipper et Scissors apparaissent rarement. Ce déséquilibre n’est pas accidentel, il reflète la réalité de la chirurgie laparoscopique, et c’est là que les performances du modèle divergent le plus nettement.
Les résultats racontent deux histoires à la fois. Le mAP@50 global atteint 0.685, et la classe dominante obtient 0.986. Mais les classes rares sont bien en dessous de 50%, conséquence directe du déséquilibre du dataset que la seule augmentation de données ne suffit pas à résoudre. Le cadre d’évaluation a été délibérément construit autour de la caractérisation des échecs : identifier où le modèle échoue, pourquoi, et ce que cela implique pour la prochaine itération. Les principaux modes d’échec incluent l’occlusion partielle par les tissus, le flou de mouvement lors des déplacements rapides des instruments, et la similarité visuelle entre certains instruments et les structures anatomiques.
La démo interactive est déployée sur Hugging Face Spaces via Gradio, permettant d’inspecter directement les comportements défaillants sur de vraies images laparoscopiques plutôt que de simplement les rapporter sous forme de métriques agrégées.
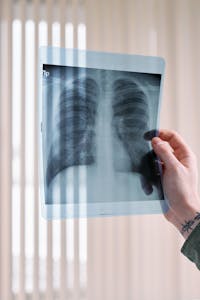
Détection de pneumonie sur radiographies thoraciques : Comparaison par Transfer Learning
L’apprentissage par transfert est l’un des outils les plus puissants en IA médicale — mais dans quelle mesure le point de départ compte-il vraiment ? Ce projet explore cette question en utilisant la détection de pneumonie sur radiographies thoraciques comme expérience contrôlée.
Les deux modèles partagent exactement le même backbone : google/vit-base-patch16-224-in21k, un Vision Transformer pré-entraîné sur ImageNet-21K avec 14 millions d’images. Le modèle de référence, nickmuchi/vit-finetuned-chest-xray-pneumonia, avait déjà été fine-tuné spécifiquement pour cette tâche. L’objectif était d’entraîner un modèle depuis ce même point de départ et de mesurer l’écart — s’il existe.
L’entraînement a suivi une approche en deux phases sur le dataset Kaggle Chest X-Ray Images (~5 800 images, classification binaire : Normal vs Pneumonie). Dans la première phase, le backbone a été gelé et seule la nouvelle tête de classification a été entraînée, permettant au modèle d’apprendre la tâche sans perturber les représentations pré-entraînées. Dans la deuxième phase, le modèle complet a été fine-tuné de bout en bout avec un taux d’apprentissage nettement plus faible, afin d’éviter l’oubli catastrophique. Une pondération des classes a été appliquée tout au long de l’entraînement pour gérer le déséquilibre 3:1 Pneumonie:Normal dans l’ensemble d’entraînement.
La démo interactive exécute les deux modèles simultanément sur n’importe quelle radiographie thoracique importée, affichant prédictions, scores de confiance et cartes Grad-CAM côte à côte — permettant de voir non seulement si les modèles sont d’accord, mais aussi où dans l’image chacun porte son attention au moment de prendre sa décision.
Compétences techniques
Une liste soigneusement sélectionnée des outils, frameworks et méthodes avec lesquels j’ai travaillé au cours de ma thèse, de mes projets portfolio et de mon apprentissage personnel. Regroupés par usage, chaque entrée comprend une courte description de la façon dont je l’ai réellement utilisé, pas seulement que je sais qu’il existe.
Python
Mon langage principal pour tout : traitement des données, entraînement de modèles, expérimentation et déploiement. De l’analyse de signaux optiques durant ma thèse à la construction et au déploiement de projets portfolio, Python a été au cœur de tout.
MATLAB
Utilisé durant la phase initiale de ma thèse pour le traitement du signal, le développement d’algorithmes et le travail sur des données optiques, avant de passer à des workflows de deep learning en Python.
PyTorch
Mon framework principal pour construire et entraîner des modèles de deep learning dans mes projets portfolio. Utilisé pour concevoir des architectures personnalisées, fine-tuner des transformers pré-entraînés et exécuter des pipelines d’entraînement de bout en bout.
TensorFlow
Mon framework principal durant ma thèse, où j’ai conçu et entraîné des architectures CNN et U-Net depuis zéro sur des datasets à grande échelle. Utilisé intensivement aux côtés de Keras tout au long de mes travaux doctoraux.
Keras
Mon interface de haut niveau de choix durant ma thèse, utilisée aux côtés de TensorFlow pour construire, tester et itérer sur des architectures de modèles tout au long de mes recherches doctorales.
scikit-learn
Utilisé tout au long de mes workflows de deep learning pour le prétraitement des données, leur préparation, les métriques d’évaluation et les utilitaires de machine learning. Une présence constante dans mes travaux de thèse et mes projets portfolio.
OpenCV
Ma bibliothèque principale pour le chargement, le prétraitement et la manipulation d’images. Utilisée intensivement tout au long de ma thèse et de mes projets portfolio pour gérer les données d’images brutes.
scikit-image
Utilisé occasionnellement pour des opérations spécifiques de traitement d’images où il offrait des implémentations plus claires qu’OpenCV, notamment pour certaines tâches de filtrage et de morphologie.
Pillow
Utilisé pour le chargement d’images simple et les tâches de manipulation basique où OpenCV aurait été surdimensionné. Fiable et simple pour la gestion rapide de fichiers.
NumPy
La colonne vertébrale de chaque calcul numérique dans mon travail. Tableaux, opérations matricielles, transformations de données : NumPy est présent à chaque étape du pipeline.
Pandas
Utilisé pour la gestion des données, l’analyse et la journalisation des expériences tout au long de ma thèse. Particulièrement utile pour gérer de grands ensembles de résultats expérimentaux et suivre les runs d’entraînement selon différentes configurations.
SciPy
Utilisé pour des tâches de calcul scientifique durant ma thèse, notamment des opérations de traitement du signal, des analyses statistiques et des méthodes numériques complémentaires à mes workflows de deep learning.
SymPy
Utilisé principalement dans un contexte d’enseignement pour démontrer les mathématiques symboliques à des étudiants de licence, rendant des concepts mathématiques abstraits plus tangibles à travers le code.
Jupyter
Mon environnement de choix pour la recherche et l’expérimentation durant ma thèse. Utilisé pour le prototypage, le test d’idées et la documentation des expériences d’une façon qui gardait code, résultats et notes au même endroit.
Google Colab
Mon environnement de référence pour les projets portfolio, combinant l’interface notebook familière avec un accès GPU gratuit. Utile pour exécuter des expériences d’entraînement sans avoir besoin de ressources de calcul locales.
Hugging Face
Là où j’héberge et partage mes modèles et démos interactives. Mes deux projets portfolio y sont déployés, et j’utilise la bibliothèque Transformers pour travailler avec des modèles de vision pré-entraînés.
Gradio
L’outil que j’utilise pour transformer des expériences de modèles en démos interactives. Mes deux projets déployés utilisent Gradio pour rendre le comportement des modèles directement inspectable par tous, sans code requis.
CUDA
Utilisé pour l’entraînement accéléré par GPU tout au long de ma thèse et de mes projets portfolio. L’exécution d’expériences à grande échelle sur des clusters HPC nécessitait de travailler directement avec les configurations CUDA et la gestion de la mémoire.
Git
Utilisé pour le contrôle de version sur tous mes projets, en suivant les expériences, les changements architecturaux et les itérations de pipeline de manière reproductible et documentée.
GitHub
Là où je stocke et versionne mes projets de code. Héberge actuellement mes travaux antérieurs sur la détection de cancer de la peau et mes expériences de développement web, les projets portfolio étant hébergés directement sur Hugging Face.