

César Hernandez Alvarez
Acerca de mí
Soy investigador con un doctorado en ingeniería biomédica, especializado en deep learning para señales físicas complejas. Mi trabajo doctoral se centró en la reconstrucción de objetos ocultos dentro de medios difusores, un problema que exigía entender la física de la luz antes de escribir una sola línea de código. Esa base da forma a cómo abordo cada problema de modelado.
Diseño y evalúo modelos de inicio a fin, desde la curación de datos crudos y las decisiones de preprocesamiento hasta el entrenamiento desde cero, el análisis de fallos y el despliegue de demos interactivas. He entrenado arquitecturas con más de 50M de parámetros sobre datasets de más de 600K imágenes y traducido experimentos de investigación en herramientas accesibles en Hugging Face. Actualmente amplío mi trabajo hacia la imagen médica multimodal y problemas con datos limitados, donde evaluar bien el modelo importa tanto como construirlo bien.
Proyectos y contribuciones
Para conocer más sobre un proyecto específico, visitar el repositorio o probar una versión demo, haz clic en los enlaces correspondientes disponibles en cada una de las tarjetas.
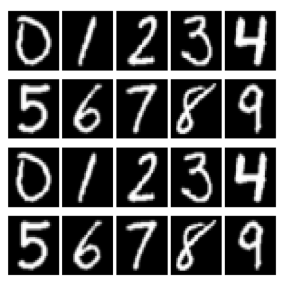
Imagenología óptica en medios dispersivos (tesis doctoral)
El objetivo de este proyecto fue mejorar la calidad de las reconstrucciones en imagen óptica a través de medios dispersivos, así como reducir el carácter aleatorio presente en este tipo de reconstrucción.
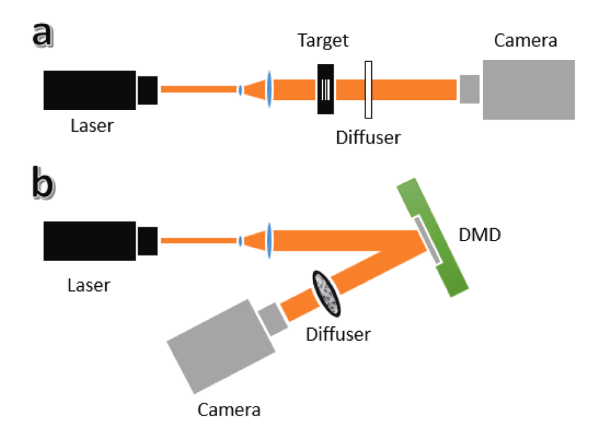
Artículo sobre hiperparámetros en procesos de optimización
Este artículo describe un método para reducir el tiempo de cómputo y la necesidad de intervención humana al ajustar los parámetros del algoritmo PSO aplicado a la reconstrucción de imágenes.
Detección de instrumentos quirúrgicos – Video laparoscópico
Estudio de fine-tuning aplicando YOLOv8s a la detección de instrumentos quirúrgicos en 7 clases, con análisis de fallos por clase, un marco de evaluación documentado y una demo interactiva en vivo.
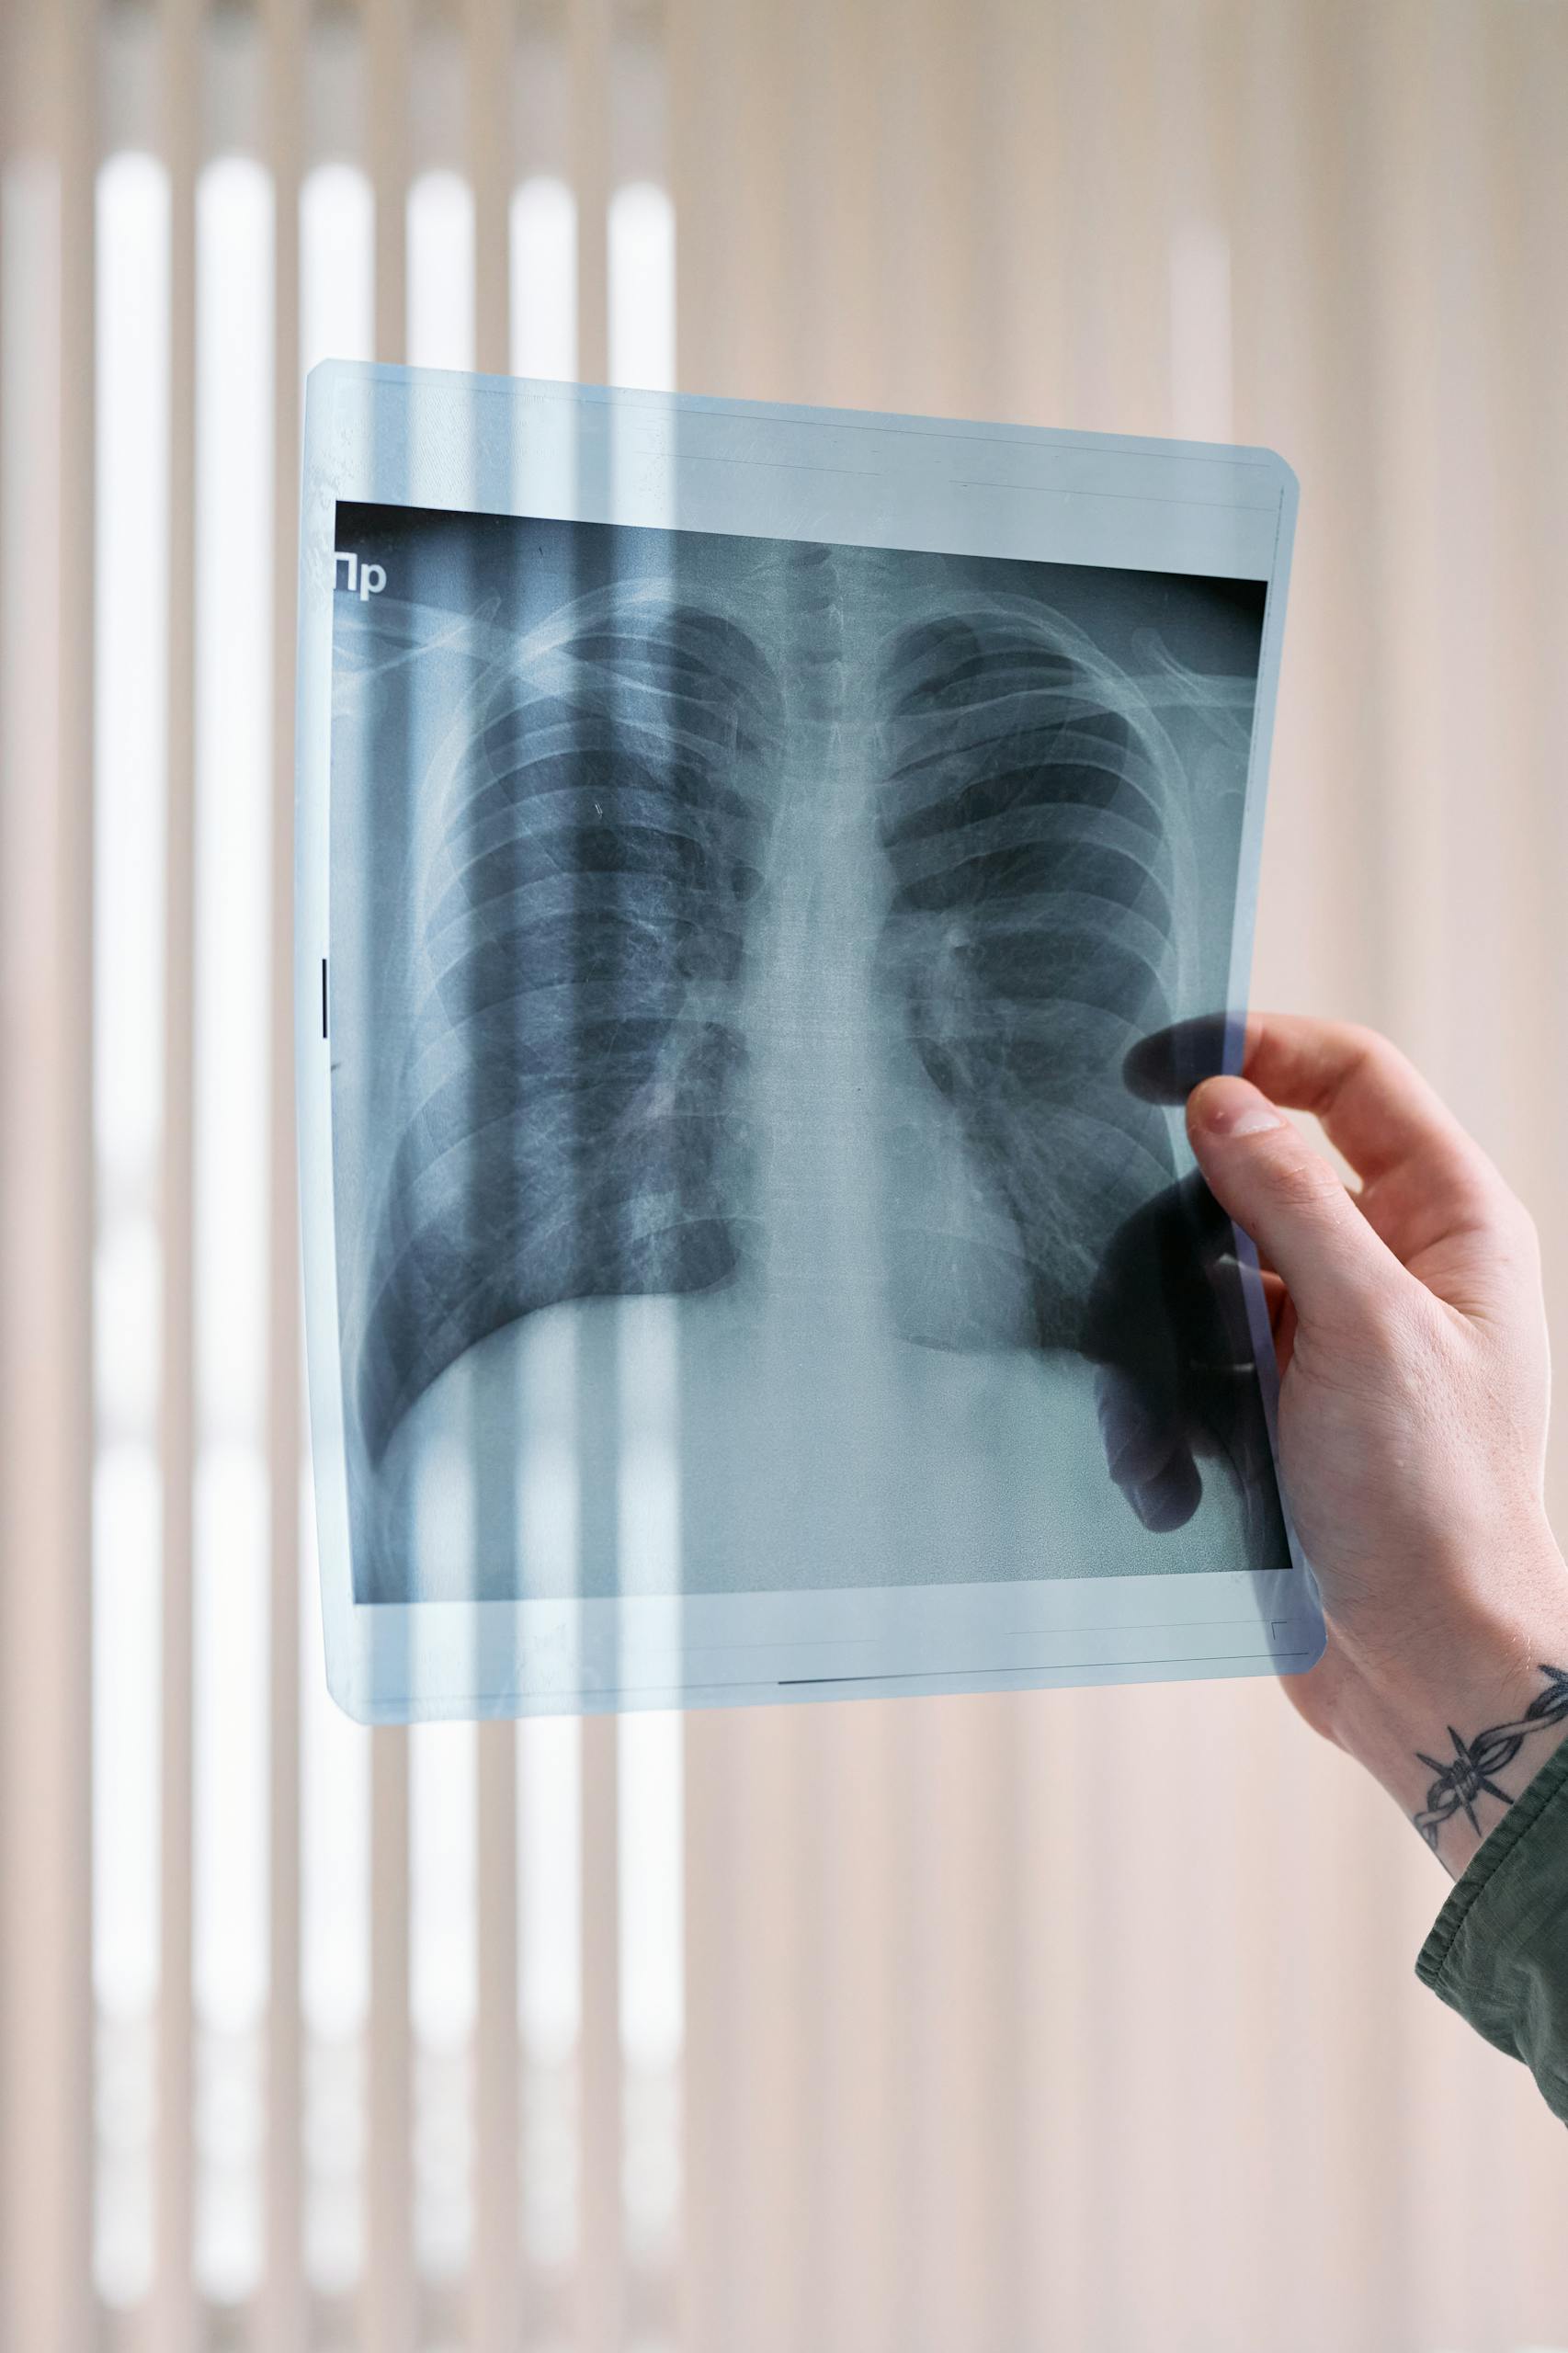
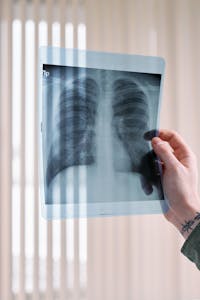
Detección de neumonía en radiografías de tórax: Comparación mediante aprendizaje por transferencia (Transfer Learning)
Estudio de aprendizaje por transferencia (Transfer Learning) que compara un ViT entrenado desde cero contra un modelo especializado de referencia, con visualizaciones Grad-CAM en paralelo y una demo interactiva.
Imagenología óptica en medios dispersivos (tesis doctoral)
Los medios turbios (o dispersivos) se refieren a materiales que no permiten el paso de la luz, como las sustancias opacas. El principal desafío al aplicar algoritmos de reconstrucción de imágenes basados en Deep Learning es que cada modelo es específico del medio con el que fue entrenado. Si el medio cambia, incluso cuando el objeto permanece igual, el desempeño del modelo disminuye significativamente.
Este problema se vuelve aún más complejo en el caso de la piel humana, que es un medio dinámico. Incluso cuando los datos de entrenamiento se recopilan de una sola persona, las propiedades ópticas de la piel cambian con el tiempo, lo que implica que las condiciones observadas durante el entrenamiento no son estables.
El objetivo de esta tesis fue mejorar la capacidad de generalización de los modelos de imagen basados en Deep Learning para la reconstrucción de objetos ocultos detrás de o dentro de medios dispersivos en sistemas ópticos. Para ello, se exploraron diversas arquitecturas de redes y estrategias de parametrización.
Los modelos presentados (Dense CNN y U-net) fueron entrenados utilizando tanto imágenes de distribución de intensidad (conocidas como speckles) como información en el dominio de Fourier derivada de dichos speckles, específicamente datos de autocorrelación y espectro de Fourier. El análisis completo y los resultados pueden consultarse en la tesis publicada, accesible mediante el enlace indicado en la tarjeta del proyecto.
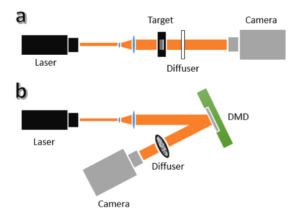
Artículo científico sobre ajuste de hiperparámetros para procesos de optimización
La obtención de imágenes a través de medios dispersivos representa un desafío importante en sistemas ópticos, ya que la información de fase de la luz se pierde en los patrones de speckles registrados detrás de un difusor u otro medio complejo. Los algoritmos tradicionales de recuperación de fase pueden reconstruir el objeto oculto a partir de mediciones de intensidad, pero dependen en gran medida de parámetros definidos por el usuario (por ejemplo, configuraciones de filtros o umbrales), que normalmente se seleccionan con base en un conocimiento previo de las características del objeto, información que no está disponible en aplicaciones reales.
Este trabajo propone el uso de la Optimización por Enjambre de Partículas (Particle Swarm Optimization, PSO), un algoritmo de búsqueda inspirado en procesos biológicos, para determinar automáticamente los valores óptimos de los parámetros necesarios para la recuperación de fase, eliminando la necesidad de ajustes manuales o supuestos específicos sobre el objeto. Al integrar PSO con un enfoque de imagen de una sola toma basado en speckles modulados por el objeto, el método logra una convergencia más rápida y una mejor calidad de reconstrucción, sin búsquedas repetidas de los mejores parámetros.
El estudio destaca cómo la combinación de técnicas de optimización con la recuperación de fase óptica puede hacer que la imagen basada en speckles sea más robusta y práctica, especialmente en situaciones donde no se dispone de información previa sobre el objeto.
Detección de instrumentos quirúrgicos – Video laparoscópico
La detección de instrumentos quirúrgicos en video laparoscópico se sitúa en la intersección de dos problemas difíciles: una distribución de clases fuertemente desequilibrada y una brecha de dominio significativa entre los modelos de visión de propósito general y las realidades de un entorno quirúrgico. Este proyecto investiga en qué medida un modelo de detección pre-entrenado puede transferirse a ese dominio con datos anotados limitados.
El modelo es YOLOv8s, pre-entrenado en COCO, un dataset de detección de propósito general a gran escala con 80 clases de objetos. Ninguna de esas clases es un instrumento quirúrgico. La pregunta era si las representaciones visuales aprendidas sobre imágenes naturales se transferirían de forma significativa a un dominio clínico especializado, y dónde exactamente falla esa transferencia.
El fine-tuning se realizó sobre el dataset Cholec80-boxes, cubriendo 7 clases de instrumentos en 14,195 frames anotados. La distribución de clases está fuertemente sesgada: el instrumento Hook domina el dataset, mientras que clases como Clipper y Scissors aparecen raramente. Este desequilibrio no es accidental, refleja la realidad de la cirugía laparoscópica, y es donde el rendimiento del modelo diverge más marcadamente.
Los resultados cuentan dos historias a la vez. El mAP@50 global alcanzó 0.685, y la clase dominante obtuvo 0.986. Pero las clases raras cayeron muy por debajo del 50%, consecuencia directa del desequilibrio del dataset que la augmentación de datos por sí sola no resuelve. El marco de evaluación fue construido deliberadamente en torno a la caracterización de fallos: identificar dónde falla el modelo, por qué, y qué implica eso para la siguiente iteración. Los principales modos de fallo incluyen oclusión parcial por tejido, desenfoque de movimiento durante desplazamientos rápidos de instrumentos, y similitud visual entre ciertos instrumentos y estructuras anatómicas.
La demo interactiva está desplegada en Hugging Face Spaces mediante Gradio, permitiendo inspeccionar directamente el comportamiento defectuoso en frames laparoscópicos reales, en lugar de simplemente reportarlo como métricas agregadas.
Detección de neumonía en radiografías de tórax: Comparación mediante aprendizaje por transferencia (Transfer Learning)
El aprendizaje por transferencia es una de las herramientas más poderosas en IA médica, pero ¿qué tanto importa realmente el punto de partida? Este proyecto investiga esa pregunta usando la detección de neumonía en radiografías de tórax como experimento controlado.
Ambos modelos comparten exactamente el mismo backbone: google/vit-base-patch16-224-in21k, un Vision Transformer pre-entrenado en ImageNet-21K con 14 millones de imágenes. El modelo de referencia, nickmuchi/vit-finetuned-chest-xray-pneumonia, ya había sido fine-tuneado específicamente para esta tarea. El objetivo fue entrenar un modelo desde ese mismo punto de partida y medir la diferencia – si es que existe.
El entrenamiento siguió un enfoque de dos fases sobre el dataset Kaggle Chest X-Ray Images (~5,800 imágenes, clasificación binaria: Normal vs Neumonía). En la primera fase, el backbone se congeló y únicamente la nueva cabeza de clasificación fue entrenada, permitiendo que el modelo aprendiera la tarea sin alterar las representaciones pre-entrenadas. En la segunda fase, el modelo completo fue fine-tuneado de extremo a extremo con una tasa de aprendizaje considerablemente más baja, para evitar el olvido catastrófico. Se aplicó ponderación de clases durante todo el entrenamiento para manejar el desbalance 3:1 Neumonía:Normal en el conjunto de entrenamiento.
La demo interactiva ejecuta ambos modelos simultáneamente sobre cualquier radiografía de tórax que se suba, mostrando predicciones, puntajes de confianza y mapas Grad-CAM en paralelo – lo que permite ver no solo si los modelos coinciden, sino también en qué parte de la imagen se está fijando cada uno al momento de tomar su decisión.
Habilidades técnicas
Una lista cuidadosamente seleccionada de las herramientas, frameworks y métodos con los que he trabajado a lo largo de mi doctorado, proyectos de portfolio y aprendizaje autodidacta. Agrupados por propósito, cada entrada incluye una breve descripción de cómo lo utilicé realmente, no solo que sé que existe.
Python
Mi lenguaje principal para todo: procesamiento de datos, entrenamiento de modelos, experimentación y despliegue. Desde el análisis de señales ópticas durante mi doctorado hasta la construcción y despliegue de proyectos de portfolio, Python ha estado en el centro de todo.
MATLAB
Utilizado durante la fase inicial de mi doctorado para el procesamiento de señales, el desarrollo de algoritmos y el trabajo con datos ópticos, antes de hacer la transición a workflows de deep learning en Python.
PyTorch
Mi framework principal para construir y entrenar modelos de deep learning en mis proyectos de portfolio. Utilizado para diseñar arquitecturas personalizadas, hacer fine-tuning de transformers pre-entrenados y ejecutar pipelines de entrenamiento de extremo a extremo.
TensorFlow
Mi framework principal durante mi doctorado, donde diseñé y entrené arquitecturas CNN y U-Net desde cero sobre datasets a gran escala. Utilizado extensamente junto con Keras a lo largo de mi trabajo doctoral.
Keras
Mi interfaz de alto nivel de elección durante mi doctorado, utilizada junto con TensorFlow para construir, probar e iterar sobre arquitecturas de modelos a lo largo de mi investigación doctoral.
scikit-learn
Utilizado a lo largo de mis workflows de deep learning para el preprocesamiento de datos, su preparación, métricas de evaluación y utilidades de machine learning. Una presencia constante tanto en mi trabajo de doctorado como en mis proyectos de portfolio.
OpenCV
Mi biblioteca principal para la carga, preprocesamiento y manipulación de imágenes. Utilizada extensamente a lo largo de mi doctorado y proyectos de portfolio para gestionar datos de imágenes en bruto.
scikit-image
Utilizado ocasionalmente para operaciones específicas de procesamiento de imágenes donde ofrecía implementaciones más limpias que OpenCV, especialmente para ciertas tareas de filtrado y morfología.
Pillow
Utilizado para la carga sencilla de imágenes y tareas de manipulación básica donde OpenCV habría sido excesivo. Fiable y simple para la gestión rápida de archivos.
NumPy
La columna vertebral de cada cálculo numérico en mi trabajo. Arrays, operaciones matriciales, transformaciones de datos: NumPy está presente en cada etapa del pipeline.
Pandas
Utilizado para la gestión de datos, análisis y registro de experimentos a lo largo de mi doctorado. Especialmente útil para gestionar grandes conjuntos de resultados experimentales y hacer seguimiento de los runs de entrenamiento bajo diferentes configuraciones.
SciPy
Utilizado para tareas de cómputo científico durante mi doctorado, incluyendo operaciones de procesamiento de señales, análisis estadístico y métodos numéricos que complementaban mis workflows de deep learning.
SymPy
Utilizado principalmente en un contexto docente para demostrar matemáticas simbólicas a estudiantes de licenciatura, haciendo más tangibles los conceptos matemáticos abstractos a través del código.
Jupyter
Mi entorno de elección para la investigación y la experimentación durante mi doctorado. Utilizado para prototipar, probar ideas y documentar experimentos de una forma que mantenía código, resultados y notas en un mismo lugar.
Google Colab
Mi entorno de referencia para los proyectos de portfolio, combinando la interfaz de notebook familiar con acceso gratuito a GPU. Útil para ejecutar experimentos de entrenamiento sin necesitar recursos de cómputo locales.
Hugging Face
Donde alojo y comparto mis modelos y demos interactivas. Mis dos proyectos de portfolio están desplegados allí, y uso la biblioteca Transformers para trabajar con modelos de visión pre-entrenados.
Gradio
La herramienta que uso para convertir experimentos de modelos en demos interactivas. Mis dos proyectos desplegados usan Gradio para hacer el comportamiento del modelo directamente inspeccionable por cualquiera, sin necesidad de código.
CUDA
Utilizado para el entrenamiento acelerado por GPU a lo largo de mi doctorado y proyectos de portfolio. La ejecución de experimentos a gran escala en clusters HPC requería trabajar directamente con las configuraciones CUDA y la gestión de memoria.
Git
Utilizado para el control de versiones en todos mis proyectos, haciendo seguimiento de experimentos, cambios arquitectónicos e iteraciones de pipeline de forma reproducible y documentada.
GitHub
Donde almaceno y versiono mis proyectos de código. Actualmente aloja mis trabajos anteriores sobre detección de cáncer de piel y experimentos de desarrollo web, con los proyectos de portfolio alojados directamente en Hugging Face.